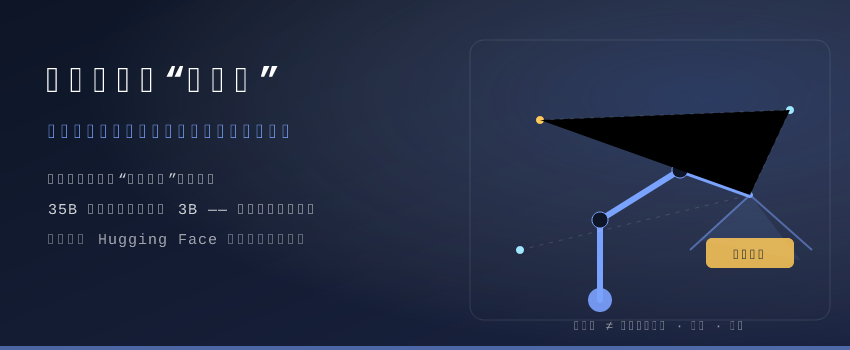
机器人干活时,最容易栽在“看错眼”上。 画面里物体看起来靠上,不等于它在真实空间里更高;换个角度拍,沙发样子变了,可它还是同一张沙发;画面里东西动了,可能是物体自己在动,也可能只是摄像头转了一下。这些差别人一眼就分得清,机器人却经常搞混——认错东西、算错方向、把没做完的步骤当成做完了。 据官方消息,招商局先进技术研究院下属的狮子山人工智能实验室近日发布了一个专门解决这类问题的模型:具身推理视觉语言模型「驭物™ Lion-ER-35B-A3B」。 不想再堆数据,改从“要会什么”倒推过去几年,机器人数据越攒越多,但业内逐渐发现一个尴尬事实:更多数据,并不等于更多能力。同样的数据集,只调整不同来源的权重,下游表现就明显变化。 这个团队换了思路,先做一张“能力蓝图”:把机器人该会的本事拆成实体、空间、时序、物理、可供性、任务、社会、证据 8 个大类、39 项细分能力,再按这张图去设计训练题,而不是先抓一堆视频再想怎么用。他们把这一步叫“能力编译”——先想清楚需要什么场景、看几张图、问什么问题、答案凭什么算对。 标准里有一条很硬:保留有证据的难题,排除缺证据的伪难题。也就是说,如果给模型的画面根本不足以推出答案,这题就不收;模型答错也不等于题错了,还得人工复核。 最终用来训练的监督样本是 31.2 万条。评测不再是训练完才看的成绩单,而是下一轮造数据的起点:从错题里找短板,再去约 430 万条素材池里找“推理逻辑相同、场景不同”的新素材补上。 35B 的个头,每次只动 3B模型采用 MoE 混合专家架构,总参数约 35B,每个字(Token)只激活约 3B 参数,所以推理开销不大。 结果是在十项主流具身相关基准上全部涨分,等权综合均分 65.29。其中空间放置测评 Where2Place 得 64.28(比基座 +9.30 分),具身推理基准 ERQA 得 64.38(+6.19 分,其中轨迹理解子类 +12.12 分),空间推理基准 SAT 达到 89.33。 几个直观例子:两帧画面里瓶子整体上移,问“摄像头往哪转”——对比模型基本答错,它能判断出是相机向下转;四条候选轨迹里选一条能真的碰到充电器的,它也没被“看起来通向目标”的假路线骗走;三张照片推断挂画在拍摄者哪一侧,它能把画面拼成一张“心理地图”再换算视角。 已开源,能直接下载据了解,这个模型已在 Hugging Face 开源权重(BF16 Safetensors 格式,兼容 Transformers、vLLM、SGLang 等主流推理框架),地址:https://huggingface.co/cmriat/lion-ER-35B-A3B 团队表示,后续会面向具身 Agent 拓展工具调用、多轮交互与执行反馈的训练数据,探索长程任务里的连续决策和失败恢复。 对普通人来说,这事儿的意义不在分数:机器人真正走进家庭和工厂,卡点往往不是“会不会聊天”,而是“会不会看错”。这类把数据造法讲清楚、还把权重放开的工作,比又一个聊天模型的发布更接近那一步。 来源:量子位《不靠堆砌数据,让机器人看懂真实物理世界 | 招商局狮子山实验室发布「驭物™ Lion-ER-35B-A3B」具身推理模型》(2026-11-04) 原文链接:https://www.qbitai.com/2026/11/507586.html 模型地址:https://huggingface.co/cmriat/lion-ER-35B-A3B |
 业界动态范式放出Phai双模型:350亿参数只激活30亿2026-11-20
 业界动态思维链一作Jason Wei离开Meta:不发模型了2026-11-19
 业界动态材料科学智能体MatOS正式开源:AI自己攒经2026-11-18



 糖糊碌