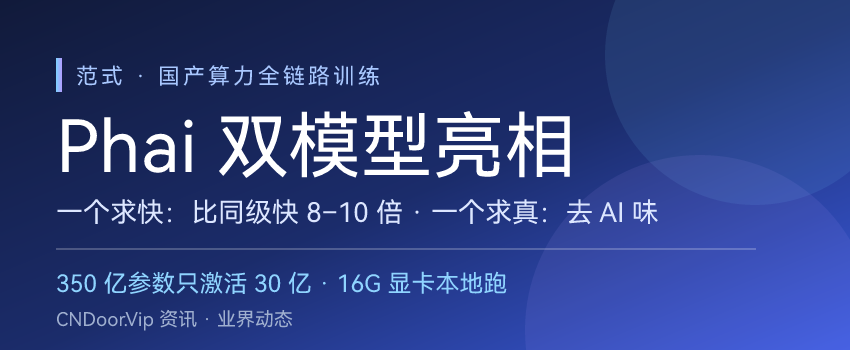
11月18日,企业级AI厂商范式(第四范式)在没有预热的情况下,一口气放出两款自家"Phai"系列模型:语言模型 Phai-A1 主打快,视频模型 Phai-M1 主打真。据官方说法,前者在同等质量下,响应速度能比同参数级别的模型快8到10倍;后者生成的视频"AI感"更弱、画面更接近真人影视。据了解,上线当天体验入口一度被挤到服务器吃紧。
Phai-A1:不是单点魔法,是四个乘数叠加据官方公布的测试,在相同的单张消费级显卡(RTX 3090)和相同版本的代码 Agent 任务下,Phai-A1 的响应速度比 Qwen 27B 快约8至10倍。拆开看,主要靠四件事:一是稀疏激活——总参数350亿,但每个 token 只调用约30亿参数,算力先降一个量级;二是原生百万级上下文,长任务跑到几十万 token 仍不拖慢,才算真的快;三是后训练阶段专门压缩"思考路径",少写没用的推理步骤,直接给可执行答案;四是能把模型放到本机跑,省掉 API 往返和排队。 官方称,Phai-A1 支持16G显存的消费级显卡本地部署,另有两个24G显存量化版本可选,适合对数据合规有要求的企业。 Phai-M1:专治"AI味"据官方介绍,M1 面向影视级生产场景,围绕真人影视素材做训练与优化,重点人物表现、画面细节和整体质感;还把音画同步当成核心卖点——人对音画错位极敏感,偏差超过约100毫秒就能察觉,而这恰恰是AI视频最容易露馅的地方。效率上,官方给出的数字是3分钟生成15秒高像素成片。 另一层看点:训练跑在国产算力上据了解,Phai-A1 并非从零训练一个基础大模型,而是基于开源模型做专项研发,后训练与强化学习流程在华为昇腾平台上完成。对行业来说,这释放了一个信号:以昇腾为代表的国产算力,正在从"能推理"往"能训练"延伸。范式此前在异构算力管理上的开源项目 HAMi 已进入 CNCF 孵化级,其国产芯片模型适配社区 ModelHub XC 的芯模适配组合也已突破30万组。 值得一提的是,范式把模型和自家的 ModelHub XC、HAMi、PhanthyCode、PhanthyMovie 等上层应用打通,形成"模型研发—算力管理—应用落地"的闭环。这条路和企业级厂商的打法一致:模型不是孤立产品,而是能被真实业务反哺的一环。 至于"快"和"真"背后的更多技术细节,官方表示技术报告后续会公开。 来源:InfoQ《快与真:范式首批国产算力训练的Phai系列模型,究竟有什么不同》 原文链接:https://www.infoq.cn/article/DQlimzDy7bqiZ3mc5Vvq |
 业界动态范式放出Phai双模型:350亿参数只激活30亿2026-11-20
 业界动态思维链一作Jason Wei离开Meta:不发模型了2026-11-19
 业界动态材料科学智能体MatOS正式开源:AI自己攒经2026-11-18



 糖糊碌